使用 OpenCode 進行文件整理
本次教學將介紹 OpenCode 的基本操作,並實際運用 OpenCode 協助進行文件內容整理,提升文書處理與資料整理的效率。
一、 認識 OpenCode
1. OpenCode 是什麼?可以做哪些事?
OpenCode 是一個 AI 助手工具。和一般網頁版的 AI 聊天相比,最大的差別是:它可以直接讀取你指定資料夾裡的檔案,也能依指示建立或修改檔案,不必一直複製、貼上。
| 網頁版 AI 聊天 | OpenCode | |
|---|---|---|
| 讀檔案 | 多半要自己貼上或上傳 | 直接讀取工作資料夾裡的檔案 |
| 產出成果 | 結果在對話框裡,要自己複製 | 可以直接存成檔案 |
| 風險 | 貼上什麼,就送出什麼 | 它能讀到整個資料夾,也可能改到檔案,要特別留意 |
能處理哪些事,取決於你選的模型
OpenCode 本身只是「操作介面」,真正在思考的是背後的 AI 模型。模型不同,能接受的輸入就不同:
| 模型類型 | 可以輸入 | 適合的工作 |
|---|---|---|
| 多模態模型 | 文字,加上圖片、文件等 | 看圖說明、讀取截圖或掃描內容、整理圖文並茂的資料 |
| 純文字模型 | 只有文字(txt、md、csv 等) | 摘要、改寫、整理條列、比對文字內容 |
2. 使用上的限制
目前使用的是 OpenCode 提供的免費模型。免費不代表沒有條件,以下是查核官方文件後整理的重點:
| 限制類型 | 實際情況 |
|---|---|
| 開放時間 | 多數免費模型是「限時提供」,供應商藉此蒐集回饋、改進模型,沒有永久保證。模型清單會不定時調整。 |
| 用量與速率 | 官方文件沒有公布免費模型的每分鐘或每日具體上限,不過仍可能遇到「請求過多」之類的暫時限制。 |
| 一次能處理的量 | 每個模型都有「上下文」上限,超過會被截斷或遺忘。 |
| 資料政策 | 各模型不同,部分免費模型在免費期間可能把資料用來改進模型。 |
資料來源:OpenCode Zen 官方說明(opencode.ai/docs/zen)。模型與條件隨時可能更新,請以官方頁面與實際畫面為準。
3. 為什麼使用 OpenCode?
許多免費的 AI 服務,常常只能問幾個問題就達到使用量上限,要等一段時間或付費才能繼續。OpenCode 提供多個免費模型,依我們的使用經驗,Token 額度相對充足,足以完成一整件文書工作,而不是問兩三次就被打斷。
| 一般免費 AI 服務 | OpenCode 的免費模型 | |
|---|---|---|
| 可使用的量 | 常常幾次提問就達上限 | 額度相對寬裕,可連續處理一件工作 |
| 處理檔案 | 要自己貼上或上傳 | 直接讀取資料夾裡的檔案、直接存成檔案 |
4. 如何使用?
詳細的操作畫面與步驟,請參閱 第 5 章。
二、 提示詞(Prompt)
1. 提示詞是什麼?
提示詞(Prompt)就是使用者輸入給 AI 的指令。
想像你要把一件事交給剛到職的新同仁。如果只說「幫我整理一下」,他一定會回頭問:整理成什麼?給誰看?要多詳細?所以這些答案,要一開始就寫進去。
2. 比較:模糊與精確的提示詞
同一份資料,只換提示詞,結果會差多少?先看兩種寫法:
假設要整理「資科管系」資料夾中的「資科管-115【日四技】科目表.xlsx」,希望 AI 整理出資科管系115學年第一學期的專業必修及專業選修的課程:
請幫我整理這份文件,並整理出這學期的開課內容。
資料夾中的哪份文件?AI不知道這學期是第幾學年、學期?整理成什麼內容?
# 115-1 課程資料整理

1. 文件整理

01_data/ 共 4 群:

- 總表2-1當學期開課清冊(含推廣教育學分班).xlsx:主檔,115-1 全校開課,共 1682 筆。欄位:學系/科、學制、年級、班級、課號、課程名稱、必/選修、學分數、授課教師、星期節次、上課地點、修課人數、註記。
- 總表2-1 ... - 複製.docx:內容與主檔相同,為 Excel 誤存成 .docx,不需另行處理。
- 生科系_日四技/:112、113、114、115 學年度科目表 PDF,對應 4、3、2、1 年級。
- 資科管系/:112-115 日四技 PDF + 114 日四技/進四技、115 日四技 xlsx。
- 應外科_五專/:111-115 學年度科目表 PDF,對應 5、4、3、2、1 年級。
- others/courses.xlsx、curr_115.pdf:前者與主檔相同,後者為 115 課程總覽。

## 2. 這學期開課內容(三系共 163 門)

已產出:01_data/115-1開課整理_生科資科管應外.xlsx,含說明總覽 + 7 分頁。

| 系科 | 學制 | 1年級 | 2年級 | 3年級 | 4年級 | 5年級 | 小計 |
| --- | --- | ---: | ---: | ---: | ---: | ---: | ---: |
| 生科系 | 日四技 | 7 | 6 | 6 | 4 | - | 23 |
| 生科系 | 日碩士班 | 3 | 4 | - | - | - | 7 |
| 生科系 | 進二技 | - | 7 | - | - | - | 7 |
| 資科管系 | 日四技 | 10 | 6 | 11 | 16 | - | 43 |
| 資科管系 | 進四技 | - | 7 | 8 | 9 | - | 24 |
| 應外科 | 日五專 | 7 | 7 | 7 | 12 | 12 | 45 |
| 應外系 | 日四技 | - | - | 11 | 3 | - | 14 |

重點課程舉例

- 生科日四技 1 年級:生物學(一)、生物學實驗、普通化學與實驗、生物科技導論。
- 生科日四技 4 年級:生技實務實習、產業實習(一) 9 學分、實務專題製作。
- 資科管日四技 1 年級:計算機概論、程式設計、網頁製作、科技數學;4 年級多實習/專題。
- 應外五專 1-3 年級:聽講、會話、寫作序列;4-5 年級:翻譯習作、進階閱讀、實務專題、海外見習。

3. 其他資料

全校 1682 筆中另有:

- 通識:395 筆
- 護理:354 筆
- 其他系科與學制課程

若需進一步整理,可再製作全校版課程整理表。
請閱讀 「資科管系」資料夾中的「資科管-115【日四技】科目表.xlsx」。
規則如下:
1. 檔名包含115代表一年級,114代表二年級,以此類推。
2. 檔名上有學制名稱,如{日四技}、{進四技}等。
3. {建議修課學年}為115且{建議修課學期}為1代表115學年度第一學期
請用表格列出115學年度第一學期的專業必修及選修課程,並按照以下欄位輸出表格:
學制、年級、課程序號、科目名稱、專業必/選修、學分數
依 資科管系/資科管-115【日四技】科目表.xlsx,工作表 01-科目表 篩選:

- 學制:【日四技】→ 日四技
- 年級: 檔名 115 → 一年級
- 學期: 建議修課學年=115 且 建議修課學期=1 → 115學年度第一學期
- 類別: 專業必修、專業選修

共 6 門:

| 學制 | 年級 | 課程序號 | 科目名稱 | 專業必/選修 | 學分數 |
| --- | --- | ---: | --- | --- | ---: |
| 日四技 | 一年級 | 2 | 管理學 | 專業必修 | 2 |
| 日四技 | 一年級 | 3 | 資訊管理導論 | 專業必修 | 2 |
| 日四技 | 一年級 | 4 | 科技數學 | 專業必修 | 3 |
| 日四技 | 一年級 | 5 | 計算機概論 | 專業必修 | 3 |
| 日四技 | 一年級 | 6 | 電腦網路概論 | 專業必修 | 2 |
| 日四技 | 一年級 | 94 | Python程式設計 | 專業選修 | 3 |

同為 115學年度第一學期,另有通識課程 4 門,不列入上述專業必修/專業選修表:

| 科目名稱 | 學分數 |
| --- | ---: |
| 中文閱讀與職場應用(一) | 2 |
| 生活情境英文(一) | 2 |
| 運動與健康(一) | 2 |
| 環境永續與服務實踐(一) | 1 |
3. 如何設計提示詞?
設計提示詞時,請回答下面幾個問題:
| 要素 | 要回答的問題 | 範例 |
|---|---|---|
| 角色 | AI 扮演什麼角色? | 你是學校教務處的行政助理,熟悉行政文件與會議紀錄撰寫。 |
| 資料來源 | AI 要根據什麼資料處理? | 請根據我提供的會議逐字稿進行整理。 |
| 規則 | 處理資料時要遵循什麼原則? | 將口語內容整理成正式、簡潔的行政用語,保留重要討論內容與結論。 |
| 任務 | AI 具體要做什麼? | 將會議逐字稿整理成一份可供主任快速閱讀與簽核的正式會議紀錄。 |
| 輸出 | 最後的成品要長什麼樣子? | 分成「討論事項」、「決議事項」、「待辦事項」三部分,其中待辦事項以表格呈現,包含事項、負責人及期限。 |
| 限制 | 哪些事不能做? | 不得自行新增逐字稿中沒有的內容,資訊不明確時不要自行推測。 |
【角色】你希望 AI 扮演什麼角色?
【資料來源】明確說明 AI 要根據的資料來源
【規則】處理資料時要遵循什麼原則?
【任務】說明要做的事
【輸出】例如:5 點條列/表格/300 字以內
【限制】只根據資料內容回答;資料沒寫的請標示「資料未提及」,不要猜測。
三、 詞元(Token)
1. Token 是什麼?
AI 無法直接理解人類輸入的完整文字,因此會先把句子切成一小段一小段,例如一個字或一個詞,再交給模型進行處理,這些小片段就稱為 Token。
舉例來說,假設使用者輸入「我今天去學校上課」,AI 會把它切成「我」「今天」「去」「學校」「上課」等小片段,每個片段就是一個 Token, 但實際怎麼切取決於模型的分詞器(tokenizer)。
2. 哪些因素會影響 Token?
只要是送進模型的內容,幾乎都會計入輸入 token,包括你的問題、你的指令、你貼進去的文章、你附帶的背景資料、系統提示,以及同一個對話裡之前累積的訊息。你如果一直在同一個視窗追問,前面的對話內容通常也會一起被重新帶進去。 除了輸入之外,模型產生的回覆也會被計入輸出 token。也就是說,不只是你問了什麼要算,AI 回你多少內容也要算。你要求回答越長、格式越多、範例越多,輸出 token 通常就越高。
| 類型 | 舉例 |
|---|---|
| 使用者輸入 | 使用者的問題/指令、貼進去的文章、附帶的資料、系統提示詞,以及同一個對話裡之前累積的訊息 |
| AI 輸出 | AI 回答的內容、輸出的文件格式(例如 PDF、圖片)、表格、說明等 |
參考來源:AI Token 怎麼算?新手看懂最基本的計算方式
3. 比較:不同檔案格式與輸出內容對 Token 的影響
a. 檔案格式
同樣一份內容,存成不同的檔案格式,AI 讀進去所花的 token 可能差很多:
| 檔案類型 | 用量 | 本次實測 Token 使用量 |
|---|---|---|
| 純文字(txt)、Markdown | 低 | 只有文字,結構清楚,最省也最準 |
| Word、Excel | 中~高 | 轉成文字後用量適中,但表格與圖片可能跑掉 |
| 掃描版 PDF、圖片 | 高 | 要先辨識文字,不但耗用量大,也容易有錯字 |
txt 與 pdf 的 token 比較
- 準備同一份內容的兩個檔案:
輔英科技大學教職員工福利互助辦法.txt與輔英科技大學教職員工福利互助辦法.pdf。 - 分別開新對話,輸入相同的提示詞:
請閱讀輔英科技大學教職員工福利互助辦法.pdf/txt,並列出5個重點。 - 每次送出後,記錄 OpenCode 畫面上顯示的 token 用量,並截圖。
| 檔案 | 輸入 Token 用量 | 總 Token 用量 |
|---|---|---|
| txt | 1,395 | 9,596 |
| 10,003 | 14,876 |
b. 輸出內容
AI 的回答也要算 token。要求的成品越複雜,通常用得越多:- 純文字或表格:直接寫在對話裡,最省。
- 要它產出 PDF、圖片等檔案:AI 通常得先寫程式、執行、檢查結果,來回的步驟都會消耗 token,也比較容易出錯。
四、 上下文(Context)
1. 上下文是什麼?
模型在單次請求中所能處理的上下文,包含了我們輸入的提示詞、附加的背景資料,以及模型自身要生成的回覆。這些內容加起來後的總和,被限制在一個最大的 token 數量內,一旦超過這個上限,系統便可能觸發截斷或是遺忘最早的資訊,甚至直接回報錯誤。
上下文越長,AI 處理所需的運算資源與等待時間也越高。這也是為什麼許多研究致力於在不犧牲品質的前提下,用最少的 token 完成任務。
2. 超過上限會有什麼症狀?
書桌被佔滿時,AI 通常不會告訴你「放不下了」,而是用以下這些方式:
| 你會看到 | 可能的原因 |
|---|---|
| AI 忘了前面講過的話 | 對話太長,前面的內容被擠出桌面 |
| 回答只提到檔案的前半段 | 檔案太長,後半段沒有被讀進去 |
| 答案越來越籠統、漏掉細節 | 桌上東西太多,重點被淹沒 |
| 回應越來越慢 | 每次都要重新處理一大堆累積的內容 |
3. 上下文過長時,如何解決?
- 先請 AI 整理重點:可以請 AI 將目前對話濃縮成摘要,只保留重要結論、需求、限制與待辦事項。
- 開啟新的對話:將整理好的摘要貼到新對話中,再繼續討論。這樣可以保留重要脈絡,又不需要把整段舊對話都帶入新的上下文。
- 大型文件分段處理:如果文件太長,可以依章節或主題拆分後分次處理,避免一次放入過多內容。
五、 OpenCode 實作
OpenCode 會把檔案內容傳送到雲端模型處理。請先確認這份檔案沒有個資、機密,並了解免費模型的資料政策,詳見第 07 章。
1. 實作步驟
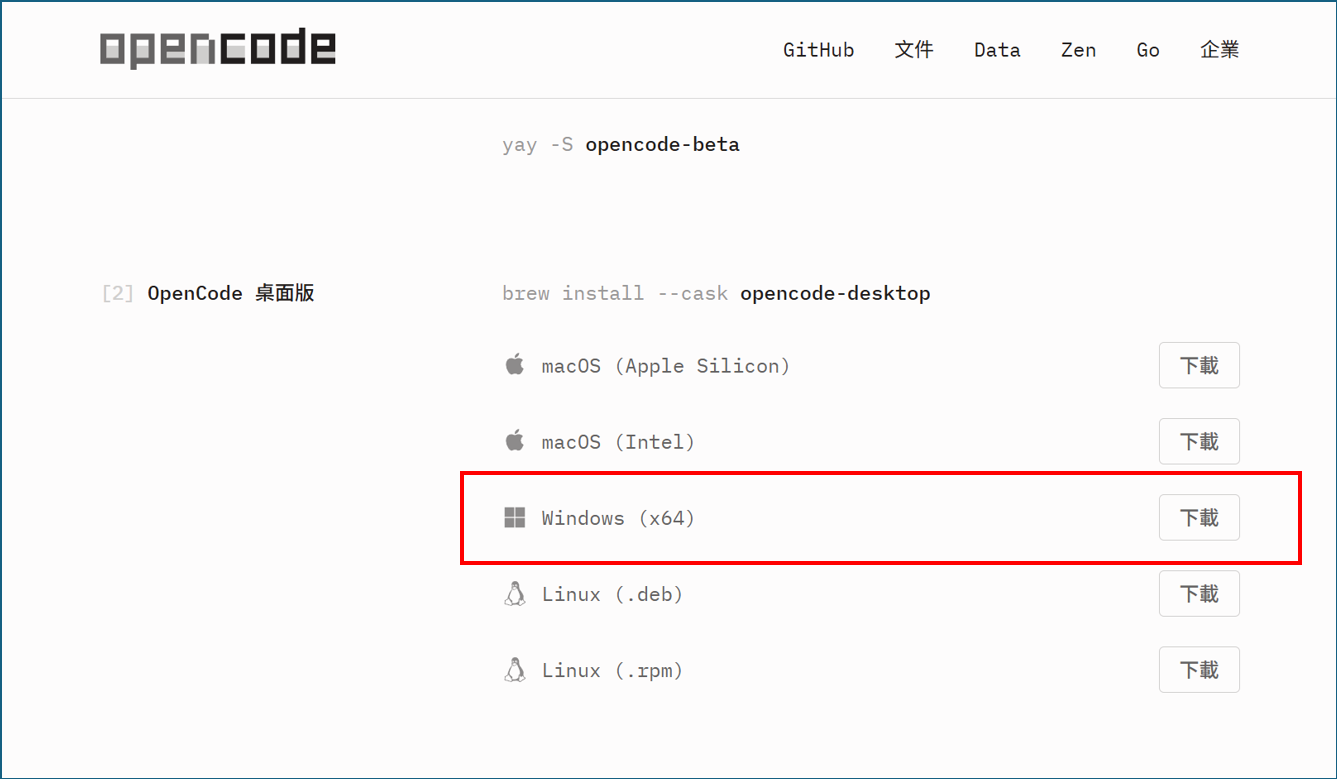
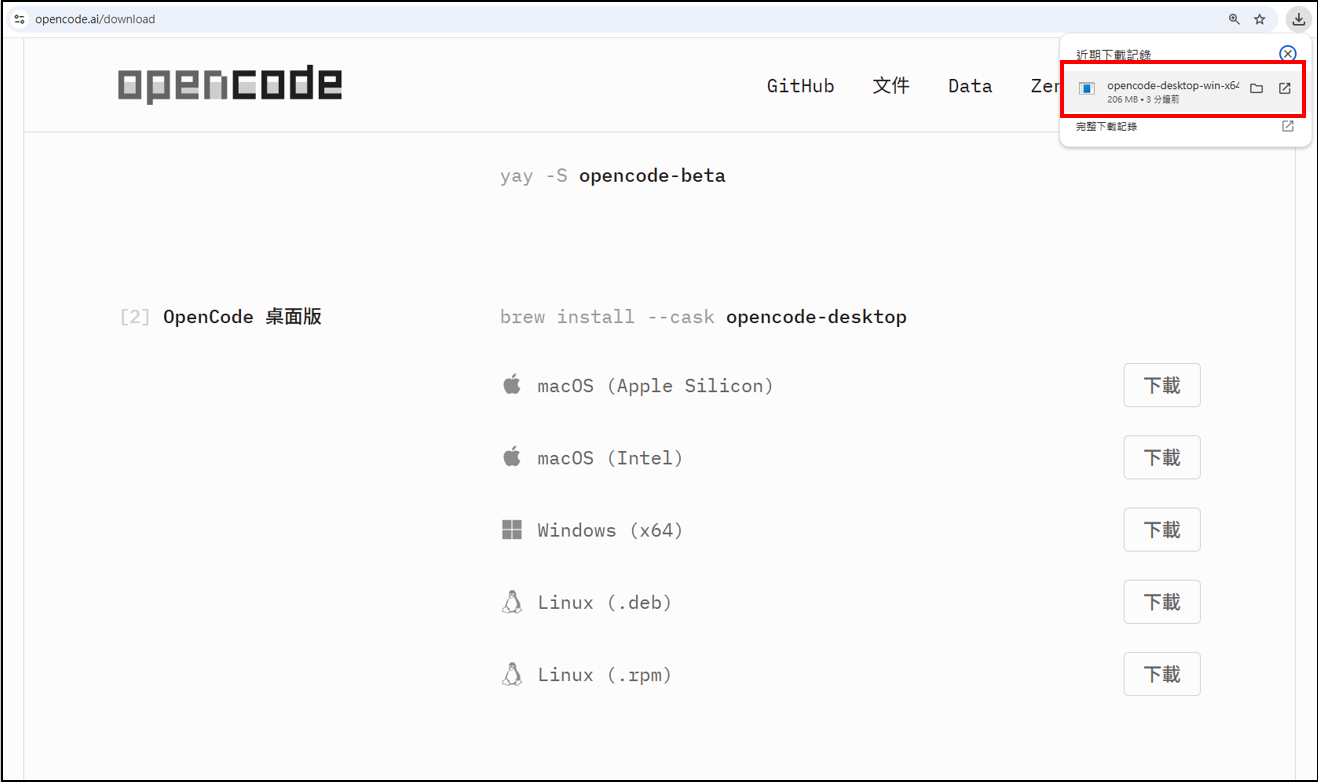
下載後,開啟 opencode-desktop-win-x64.exe檔案
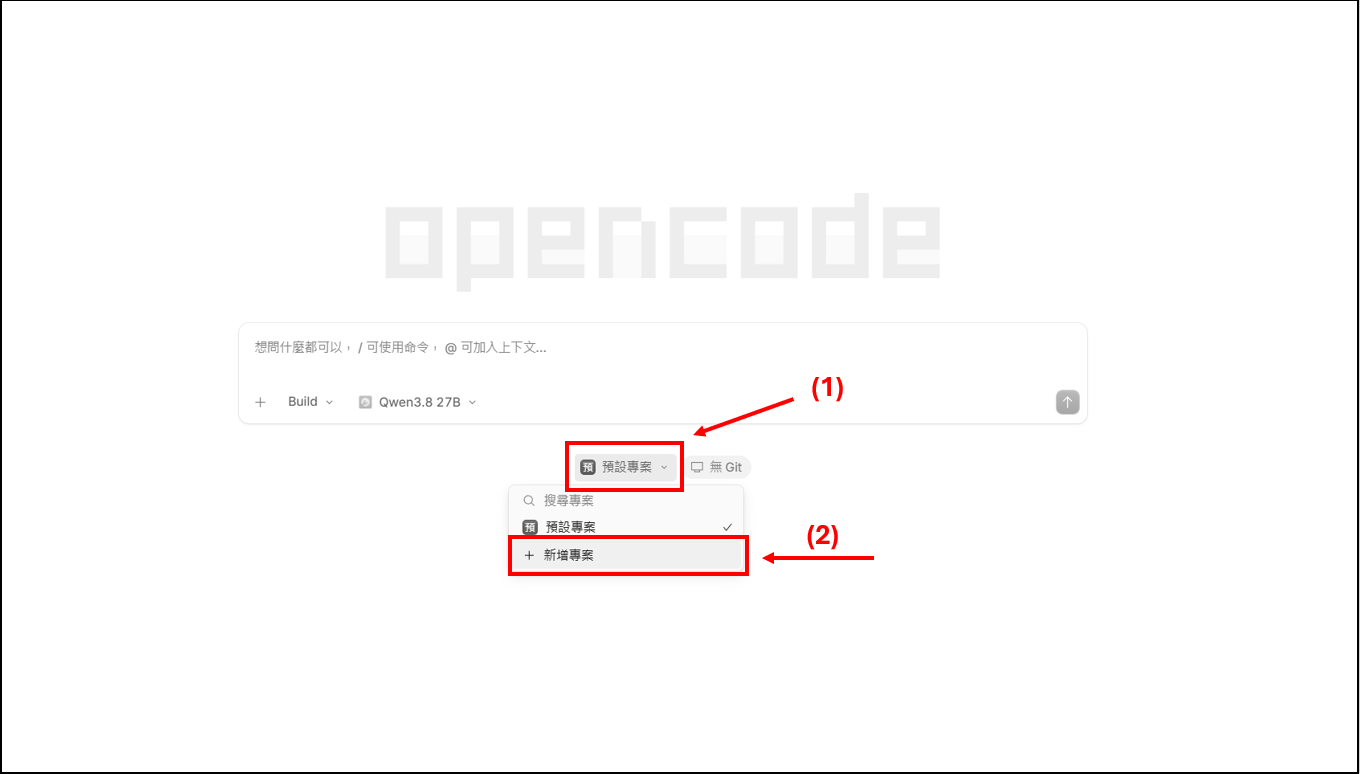
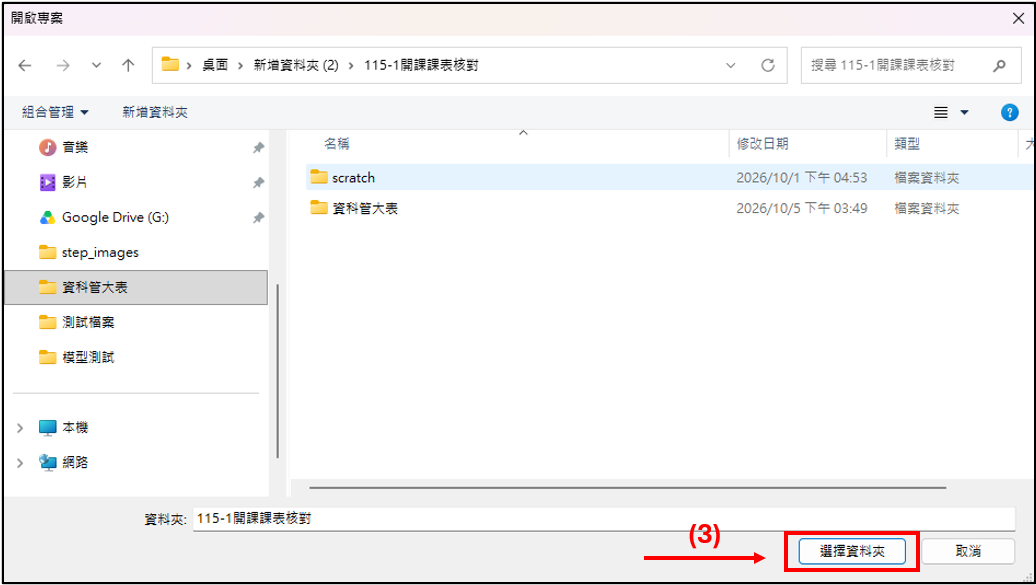
開啟 OpenCode,新增工作專案,並選擇要交由 AI 處理的資料夾
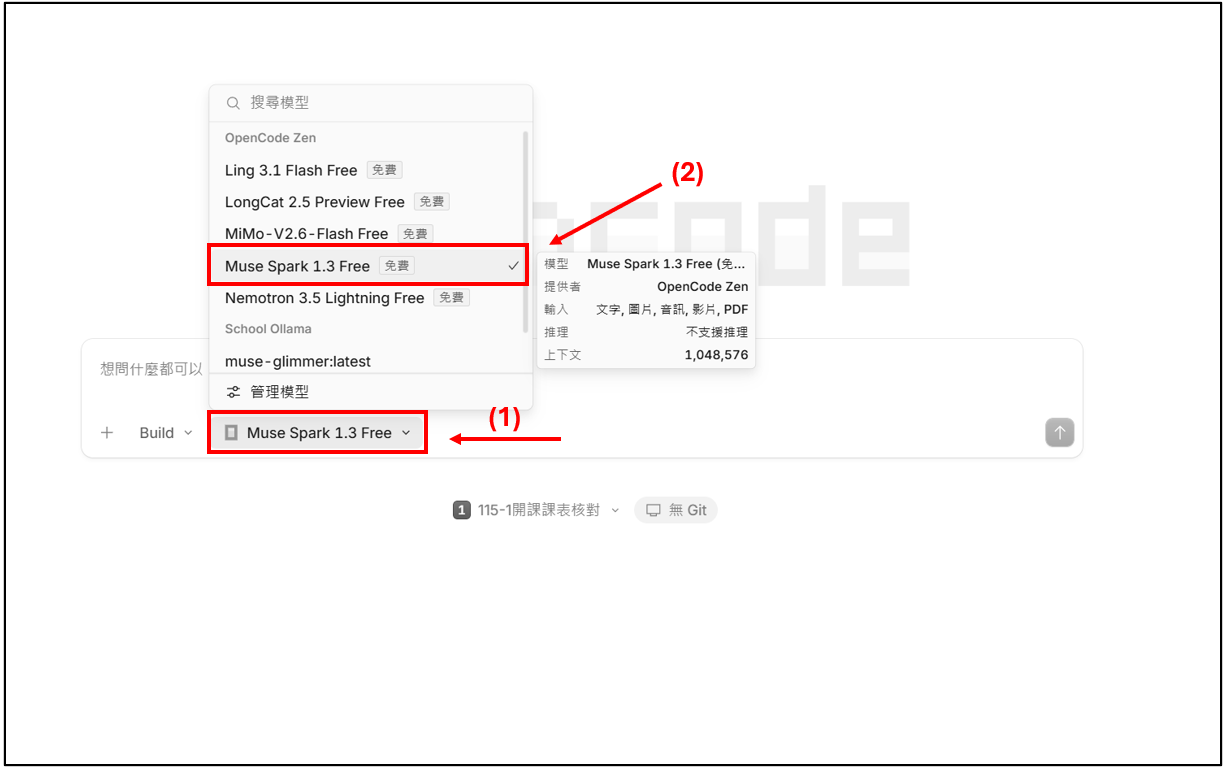
選擇模型,本次範例使用 Muse Spark 1.3 Free,可支援文字、圖片、音訊等多種資料類型輸入
輸入精確的提示詞
指定 AI 要讀哪個檔案,並套用 第 2 章 的要素:角色、資料來源、規則、任務、輸出、限制。
【角色】你是學校教務處行政助理。

【資料來源】
- 「資科管系」資料夾中的「資科管-115【日四技】科目表.xlsx」
- 「總表2-1當學期開課清冊(含推廣教育學分班).xlsx」

【判讀規則】
- 建議修課學年=115、建議修課學期=1,代表115學年度第1學期。
- 檔名中的【日四技】、【進四技】等代表學制。
- 檔名包含115代表一年級、114代表二年級...以此類推。

【任務】
1. 先從「資科管-115【日四技】科目表.xlsx」找出115學年度第1學期的「專業必修」及「專業選修」課程。
2. 再與「總表2-1當學期開課清冊(含推廣教育學分班).xlsx」比對,確認課號、課程名稱、必選修、學分數及授課老師是否一致。
3. 檢查該年級是否至少實際開設1門專業選修課。

【輸出】
請分成兩個表格輸出,不要合併成同一張表。

表一:依「資科管-115【日四技】科目表.xlsx」整理
學制、年級、學期、課程名稱、必選修、學分數

表二:依「總表2-1當學期開課清冊(含推廣教育學分班).xlsx」整理
學制、年級、課號、課程名稱、必選修、學分數、授課老師

兩個表格都必須依各自的資料來源獨立整理,不可直接沿用另一份檔案的內容,讓使用者可以人工比對兩份資料是否正確。

最後再輸出:
- 是否對應當學期開課清冊:是/否
- 每年級是否至少開1門選修課:是/否

若兩份資料有差異,請簡要列出差異項目。

最後再列出:
- 是否對應當學期開課清冊:是/否,若有差異請列出差異項目
- 每年級是否至少開1門選修課:是/否

【限制】
只根據檔案內容判斷;文件未提供的資料請標示「文件未提及」,不得自行猜測。
AI 輸出結果
表一:科目表資料

依「資科管-115【日四技】科目表.xlsx」(01-科目表)整理。
條件:建議修課學年 = 115、建議修課學期 = 1、類別 = 專業必修/專業選修

| 學制 | 年級 | 學期 | 課程名稱 | 必選修 | 學分數 |
|---|---|---:|---|---|---:|
| 日四技 | 一年級(115) | 1 | 管理學 | 專業必修 | 2 |
| 日四技 | 一年級(115) | 1 | 資訊管理導論 | 專業必修 | 2 |
| 日四技 | 一年級(115) | 1 | 科技數學 | 專業必修 | 3 |
| 日四技 | 一年級(115) | 1 | 計算機概論 | 專業必修 | 3 |
| 日四技 | 一年級(115) | 1 | 電腦網路概論 | 專業必修 | 2 |
| 日四技 | 一年級(115) | 1 | Python程式設計 | 專業選修 | 3 |

表二:當學期開課清冊資料

依「總表2-1當學期開課清冊(含推廣教育學分班).xlsx」(總表2-1_當學期開課清冊,115學年度第1學期)整理。
條件:學系/科 = 資科管系、學制 = 日四技、年級 = 1

| 學制 | 年級 | 課號 | 課程名稱 | 必選修 | 學分數 | 授課老師 |
|---|---:|---:|---|---|---:|---|
| 日四技 | 1 | 1431 | 管理學 | 必修 | 2.0 | 沈如鵬 |
| 日四技 | 1 | 1432 | 電腦網路概論 | 必修 | 2.0 | 劉銘唐 |
| 日四技 | 1 | 1433 | 資訊管理導論 | 必修 | 2.0 | 吳姿靜 |
| 日四技 | 1 | 1434 | 計算機概論 | 必修 | 3.0 | 黃湫淑 |
| 日四技 | 1 | 1435 | 科技數學 | 必修 | 3.0 | 郭添源 |
| 日四技 | 1 | 1436 | Python程式設計 | 選修 | 3.0 | 曾光輝 |
| 日四技 | 1 | 1437 | 統計學 | 必修 | 3.0 | 張簡文添 |
| 日四技 | 1 | 1438 | 行銷管理 | 必修 | 2.0 | 沈如鵬 |
| 日四技 | 1 | 1439 | 網頁製作與應用 | 必修 | 3.0 | 唐筠 |
| 日四技 | 1 | 1440 | 程式設計 | 必修 | 3.0 | 蘇基福 |

比對結果

- 是否對應當學期開課清冊:是
- 每年級是否至少開 1 門選修課:是(1年級開設 1436 Python程式設計,選修 3.0)
檢查結果
把輸出當草稿,與原文對照:重點有沒有漏?數字、日期、人名有沒有寫對?
另存新檔、結束後開新對話
成果存成新檔案,不覆蓋原稿;下一件事請開新的對話。
六、 常見問題總結
把前面各章的重點,整理成遇到狀況時的對照表。
| 症狀 | 可能原因 | 怎麼做 |
|---|---|---|
| AI 回答速度變得很慢 | 同一個對話太長;或一次讓 AI 讀取多個檔案 | 換新視窗、一次只讀一個檔案 |
| 越聊越亂、忘了前面講的 | 對話太長,上下文被佔滿 | 先請 AI 整理重點,再開新對話並貼上摘要 |
| 回答只提到檔案的前半段 | 檔案太長,後半段沒被讀進去 | 依章節拆開分段處理,再請 AI 合併 |
| Token 很快用完、額度消耗快 | 檔案格式太重(PDF、圖片),或要求的輸出太長 | 轉成 txt 或 Markdown;限定輸出的字數與格式 |
| 答非所問 | 提示詞太模糊,或讀錯檔案 | 補上角色、任務、背景、格式、限制 |
| 回答又長又空泛 | 沒有限定格式與長度 | 指定字數、點數,或用表格呈現 |
| 回答寫到一半被截斷 | 一次要求的輸出太長 | 分段進行,或回覆「請從剛剛中斷的地方繼續」 |
| 說找不到檔案 | 在錯誤的資料夾開啟,或檔名打錯 | 確認工作資料夾檔名是否正確 |
| 模型突然不能用,或出現請求過多 | 免費模型限時開放,或遇到暫時性的頻率限制 | 稍後再試,或換一個模型 |
七、 資安與個資
目前使用的是雲端模型,請先搞清楚資料去了哪裡。
1. 使用雲端模型,代表什麼?
你輸入的文字,以及 OpenCode 讀取的檔案內容,都會傳送到外部的雲端服務處理。不同服務對資料保存多久、是否用來訓練模型,規定各不相同。因此「能不能丟」,要先看資料本身的性質,並以單位的資安規範與服務條款為準。
2. 免費模型的資料政策
OpenCode 官方表示,其模型多數遵循「零保留」政策,但部分免費模型在免費期間例外。如:免費期間,蒐集的資料可能用來改進模型、提示與回覆可能用來訓練 Meta 的未來模型:
其他模型與最新規定,請查閱官方頁面 opencode.ai/docs/zen。模型清單與政策隨時可能變動。
5. 使用 OpenCode 注意事項
- 只在工作資料夾開啟:不要在「文件」、「桌面」這種放了很多檔案的上層資料夾開啟,否則 AI 可能讀到不該讀的東西。
- 小心分享連結功能:OpenCode 有把對話分享成連結的功能(如
/share),任何拿到連結的人都可能看到內容。含機密或個資的對話,請不要使用。 - 上傳前先確認資料內容:使用 AI 處理檔案前,請先確認資料中是否包含個人資料、帳號密碼、內部機密或其他不適合提供給 AI 的資訊。